

Od publikacji mojego pierwszego artykułu o wrażeniach z pracy z asystentami AI minął już ponad rok. Przez ten rok miałem okazję obserwować, zarówno na własnym przykładzie, jak i u innych, jak popularyzacja LLM-ów zmieniła codzienną pracę. W tym artykule podsumowuję swoje dotychczasowe obserwacje i przemyślenia.
Istotnie mniej „głupich” błędów…
Przez „głupie” błędy rozumiem błędy proste do przeoczenia jak pomylenie operatorów < i > , brak obsługi jakiegoś błędu, testu jednostkowego dla istotnego przypadku czy błędy w zapytaniach SQL.
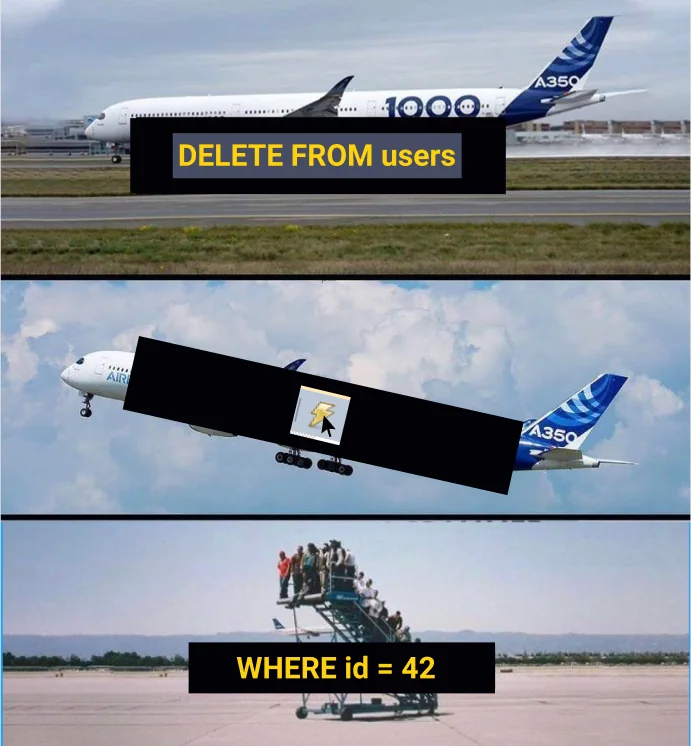
Większość takich błędów przed upowszechnieniem się AI wyłapywałem na etapie polerowania pull requestów przed wypchnięciem ich do code review. Kolejne wychwytywałem podczas code review. Czasami jednak taki błąd przechodził niezauważony i trafiał na główną gałąź. W końcu jesteśmy tylko ludźmi i z wielu powodów możemy coś przeoczyć. Moim ulubieńcem jest chyba console.log( 'dupa' ) (sic!) przy starcie aplikacji, który trafił na mastera.
Zaangażowanie LLM-ów w code review pozwoliło znacznie ograniczyć liczbę takich błędów. LLM nie bywa zmęczony, nie ma gorszego dnia ani nie jest rozkojarzony. Oczywiście skuteczność zależy m.in. od kontekstu, parametrów i rodzaju problemu. Jednak obserwowana przeze mnie tendencja pokazuje, że takie błędy zostały przeze mnie niemal wyeliminowane.
W mojej pracy zarówno Bugbot, jak i Claude Code bardzo skutecznie wychwytują takie problemy. Kilkukrotnie je testowałem, zostawiając wręcz celowo różne pułapki czy miejsca warte poprawienia. Sytuacje, gdy narzędzia te nie były w stanie ich znaleźć, były rzadkością.
…ale te poważniejsze problemy potencjalnie mogą łatwiej przemknąć
Pojawienie się agentów robiących code review może powodować złudne poczucie, że skoro agent czegoś nie zgłosił, to znaczy, że problem nie istnieje.
LLM-y są dobre w wykrywaniu problemów, które można rozpoznać na podstawie kodu, testów i dokumentacji. Mają wiedzę dotyczącą reguł tworzenia kodu, jego poprawności czy wzorców. Trudniej im jednak ocenić rozwiązania, których poprawność zależy od często niejawnych reguł biznesowych, obciążenia serwera, konfiguracji produkcyjnej lub decyzji architektonicznych. Przykładowo:
- Jak projektowane rozwiązanie zachowa się przy określonej skali systemu czy obciążeniu?
- W jakim środowisku będzie przeprowadzane wdrożenie?
- Jakie problemy najczęściej występują w konkretnych środowiskach wdrożeniowych?
- Jak dane rozwiązanie radzi sobie z typowymi problemami środowisk rozproszonych, jak niedostępność usług, opóźnienia czy race conditions?
Oczywiście wszystkie te aspekty można uwzględnić podczas projektowania promptów. Jednak wymienione przykłady to zaledwie wierzchołek góry lodowej. W pracy architektonicznej problemem nie jest samo dostarczenie modelowi informacji, lecz ustalenie, które z nich są istotne dla danej decyzji i jak zweryfikować proponowane rozwiązanie. Model może również zwyczajnie halucynować przy udzielaniu odpowiedzi.
Obecnie LLM-y potrafią pomagać w rozwiązywaniu bardziej zaawansowanych problemów architektonicznych oraz tych wymagających wiedzy domenowej. Powinny pomagać w analizowaniu różnych opcji oraz szukaniu potencjalnych luk i możliwości usprawnień. Jednak potrzebują przy tym nadzoru doświadczonego architekta. LLM-y nie powinny podejmować decyzji za nas.
Lepsze pokrycie edge case’ów, ale jakim kosztem
LLM-y pomagają mi rozszerzać listę scenariuszy brzegowych. Potrafią wskazać kombinacje warunków, o których sam bym nie pomyślał. Gdy zacząłem korzystać z Bugbota, zaskoczyło mnie, jak kreatywne i nietypowe przypadki potrafi znaleźć. Podobne rezultaty otrzymuję w pracy z Claude Code. Dodatkową korzyścią tej skrupulatności jest to, że z czasem sam zacząłem łatwiej dostrzegać takie scenariusze.
Niektóre zgłaszane przypadki rzeczywiście mają sens. Pozwalają wcześnie wychwycić istotne problemy, które mogłyby ujawnić się dopiero po wdrożeniu. Czasami jednak zgłaszane przypadki są na tyle egzotyczne, że implementacja ich obsługi w praktyce wnosi marginalną wartość. Pół biedy, jeśli ich obsługa to prosty if. Czasami jednak obsługa takich scenariuszy jest skomplikowana i odbywa się kosztem czytelności rozwiązania. Jeśli dodatkowo pokryjemy każdy taki przypadek testami jednostkowymi, możemy skończyć z kilkudziesięcioma, a nawet kilkuset dodatkowymi liniami kodu. Wszystko po to, by obsłużyć scenariusz, który być może nigdy nie wystąpi.
Może to kontrowersyjne podejście, ale w niektórych sytuacjach wolę pozostawić taki scenariusz bez obsługi, zyskując w zamian prostszą i czytelniejszą implementację. Oczywiście dotyczy to przypadków, które nie wpływają na bezpieczeństwo aplikacji czy spójność danych.
Gdy nie mam pewności, czy dany scenariusz rzeczywiście może wystąpić, czasami zostawiam dodatkowy log, który pozwala mi to zweryfikować. Jeśli przy przeglądaniu logów napotkam ten konkretny log, to jest to dla mnie jasny sygnał, że warto przyjrzeć się temu scenariuszowi głębiej.
Ośmiotysięczniki
Przed upowszechnieniem się narzędzi AI pull requesty liczące ponad 1000 linii budziły mój sprzeciw. Chodziło przede wszystkim o dyskomfort osób go sprawdzających, ale także o trudności z zarządzaniem dużymi PR-ami.
Obecnie generowanie kodu jest tak tanie, że pilnowanie rozmiaru PR-a, mam wrażenie, zeszło na dalszy plan. PR-y zawierające 2000–3000 linii zmian przestały mnie już dziwić. Oczywiście myślę tu o liniach faktycznego kodu, a nie np. automatycznie generowanych artefaktach typu lockfiles.
Przy tej skali rzetelne sprawdzenie kodu stanowi spory problem. Jednocześnie, poza sprawdzaniem kodu sami też musimy pisać własny. Doba nie jest z gumy, a liczba linii kodu do sprawdzenia drastycznie rośnie. Aby uporać się z tym problemem, możemy skracać czas przeglądu kosztem jego jakości albo delegować je agentom AI. Z moich obserwacji wynika, że na dłuższą metę oba podejścia zawodzą, a jakość projektu spada. Nawet jeśli dane zmiany podzielimy na mniejsze części lub częściowo zautomatyzujemy review, ostatecznie i tak mamy do sprawdzenia więcej kodu niż kiedykolwiek.
Generowanie dużej ilości kodu powoduje również, że ciężej jest być na bieżąco ze zmianami w repozytorium. W tej sytuacji jeszcze ważniejsza staje się dokumentacja efektów pracy. Coraz ważniejsze są porządnie przygotowane opisy tasków, raporty czy notatki podsumowujące postępy nad danymi zadaniami. Na znaczeniu jeszcze bardziej zyskują dokumenty techniczne, takie jak ADR czy RFC.
Więcej czasu na mniej istotne zadania
Chyba w każdym projekcie można znaleźć rzeczy do zrobienia „kiedyś”. Często jest to wyciągnięcie wspólnego kawałka kodu, przepisanie kodu dla lepszej czytelności, optymalizacja algorytmu, dokończenie refaktoryzacji czy inne niekrytyczne zadanie.
Do tej pory problemem było to, że kiedyś często nie nadchodziło. Często były to zadania z kategorii ważne-niepilne, które zgodnie z macierzą Eisenhowera warto zaplanować. Zwykle jednak brakowało tego planowania. Zadanie lądowało gdzieś na dnie backlogu z myślą, że jak ktoś będzie miał wolne przebiegi, to je weźmie. Niestety, najczęściej przegrywało z bieżącymi priorytetami. Agenci kodujący sprawili, że łatwiej jest znaleźć czas na takie zadania. Gdy ja skupiam się na wymaganiach biznesowych i rozwoju produktu, LLM wykonuje brudną robotę, która niewiele wnosi zarówno z perspektywy biznesowej, jak i z punktu widzenia rozwoju moich umiejętności.
Agenci kodujący świetnie nadają się do odtwórczych i powtarzalnych zadań. Przed erą LLM-ów przepisanie kodu z jednego podejścia na drugie potrafiło zajmować tyle czasu, że często było to wręcz nieopłacalne. Podobnie sytuacja wygląda z drobnymi optymalizacjami czy smrodkami w kodzie. Agenci dobrze sprawdzają się przy implementacji znanych algorytmów i wykonywaniu lokalnych zmian optymalizacyjnych. Powszechnie stosowane algorytmy są na tyle dobrze opisane, że nie obawiam się zlecać LLM-om ich wykorzystania i implementacji.
Oczywiście nie ufam im bezgranicznie. Zawsze sprawdzam, czy rozwiązanie jest optymalne i czy nie wprowadza regresji ani innych niepożądanych zmian. Zdarzało mi się np. prosić agenta o zmianę formatu asercji w testach konkretnej części systemu. Podczas tej operacji agent potrafił pominąć niektóre asercje lub dodać własne.
Coraz mniej pair programmingu
Przed erą wykorzystania LLM-ów pair programming stosowałem raczej rzadko. Od momentu, gdy pojawiły się LLM-y, niestety programuję w parze jeszcze rzadziej. LLM jest pomocnikiem dostępnym zawsze, dysponującym publicznie dostępną wiedzą i umiejącym szybciej niż człowiek przeszukać cały nasz codebase. Często omawiam z nim różne problemy i decyzje tak, jak robiłbym to z drugim człowiekiem. Zwykle jest to prostsze i szybsze niż szukanie pomocy gdzie indziej.
Ktoś mógłby powiedzieć, że LLM to nasz pair programming buddy, więc praca z LLM to pair programming. Ostatecznie przecież programujemy wspólnie. Pair programming zakłada jednak nie tylko wspólne programowanie, ale też dzielenie się wiedzą i doświadczeniem oraz budowanie relacji w zespole. Tego brakuje w pracy z maszyną.
W 2020 roku wiele osób narzekało na brak kontaktów międzyludzkich z powodu upowszechnienia się pracy zdalnej. W 2026 roku niektórzy wolą rozmawiać z „Klaudiuszami” i innymi LLM-ami niż z prawdziwymi ludźmi. Takie podejście zabija relacje międzyludzkie w zespole. Moim zdaniem praca z LLM to nie jest pair programming. Prove me wrong.
LLM-y mogą być przydatne podczas tradycyjnego pair programmingu z drugim człowiekiem. Pomagają szybciej weryfikować założenia i wdrażać omawiane zmiany. Nie powinny jednak zastępować drugiego człowieka w tym procesie.
Code review
Tematowi code review w kontekście wykorzystania AI poświęciłem dwa artykuły na blogu. Pierwszy z nich omawia wyniki testów kilku narzędzi AI, które miałem okazję wykorzystać do automatyzacji code review. W drugim artykule dzielę się obserwacjami na temat tego, jak upowszechnienie narzędzi AI zmieniło podejście do code review.
Podejście do obsługi długu technologicznego
O wykorzystaniu AI w zarządzaniu długiem technologicznym również napisałem osobny artykuł. Największe zmiany dostrzegam w podejściu do tego, kiedy warto zaciągać dług technologiczny, oraz w ocenie konsekwencji takich decyzji. Znacznie wzrosło również znaczenie dokumentowania procesu decyzyjnego, rozważanych alternatyw, konsekwencji oraz planu spłaty długu w przyszłości.
Podsumowanie
Czy LLM-y zwiększają moją produktywność? Zdecydowanie tak! Dobrze wykorzystywani agenci kodujący dają ogromną przewagę. Moim zdaniem dobry programista korzystający z AI będzie lepszy od dobrego programisty bez AI. Jednocześnie kiepski programista wspomagany przez AI niekoniecznie dorówna dobremu programiście bez AI.
Jednocześnie agenci kodujący to róża, która ma wiele kolców, mogących bardzo boleśnie ukłuć. O części z nich przeczytasz w moim artykule Dlaczego NIE warto delegować kodowania agentom AI. To jednak dopiero wierzchołek góry lodowej. Więcej na ten temat napiszę na blogu za jakiś czas. By go nie przegapić, zachęcam do zapisania się na mój mailing.
Jak zwykle zachęcam do komentowania i dzielenia się własnymi przemyśleniami.
Materiały dodatkowe
- Christoph Nakazawa – Modern Engineering Values
- Josh Collinsworth – LLMs and performative productivity
Udostępnij wpis


Poza blogiem dzielę się swoimi przemyśleniami o programowaniu na LinkedIn. Zachęcam do nawiązania kontaktu!
Szukasz taniego i dobrego VPS? Skorzystaj z Mikrusa i przy zakupie odbierz dodatkowy miesiąc usługi za darmo!
📖 Koniecznie sprawdź ofertę księgarni Helion oferującej tysiące książek dla programistów w dobrych cenach! Kupując z tego linku, pomagasz w rozwoju bloga.
📈 Szukasz księgowości dla swojej firmy? Skorzystaj z mojego polecenia i odbierz pierwszy miesiąc za 1zł netto!
Chcesz docenić moją pracę? Postaw mi kawę! 


Kolejna książka o Gicie — naucz się korzystać z Gita jak profesjonalista
"Kolejna książka o Gicie" to kompleksowy e-book, który pozwoli Ci poznać Gita od A do Z, a także liczne narzędzia dedykowane pracy z Gitem!
Dlaczego warto?
Nie przegap kolejnych artykułów
Zapisz się na mój mailing, jeśli chcesz być na bieżąco z nowymi artykułami. Wystarczy, że skorzystasz z formularza poniżej 👇
Po zapisie otrzymasz także fragment „Kolejnej książki o Gicie”.